Совместимое с Redis хранилище в памяти с нативным векторным поиском
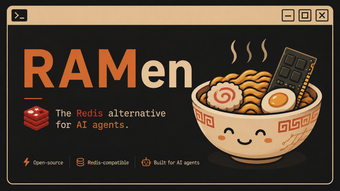
RAMen, разработанный Рохитом Днатом, является хранилищем данных в памяти, созданным для поддержки рабочих процессов на основе ИИ и памяти агентов. Этот инструмент принимает доступ в стиле ключ-значение, добавляя семантический поиск, чтобы приложения могли извлекать контент по значению, а не по точным совпадениям. Он нацелен на разработчиков ИИ и инженеров бэкенда, которым нужно локальное хранилище для снижения задержки и избежания повторных вызовов модели, и интегрируется с экосистемами агентов, использующими протокол для обмена контекстом модели.
Для каких задач вы можете его использовать?
Инструмент функционирует как хранилище в памяти, которое объединяет доступ в стиле Redis с векторным и семантическим извлечением для рабочих нагрузок ИИ. Он принимает команды протокола Redis, предоставляет семантическое кэширование для запросов на основе значений и запускает сервер протокола контекста модели, к которому агенты могут обращаться напрямую. Основная реализация написана на Go и оптимизирована для работы в памяти, поэтому сценарии использования включают быстрое локальное извлечение для памяти агента, контекста сеанса и кэшированных ответов LLM.
Насколько точен семантический поиск для рабочих процессов ИИ?
Семантическое кэширование сохраняет и извлекает ответы ИИ на основе значений, а не точных совпадений ключевых слов, что предназначено для уменьшения вызовов LLM и снижения задержки при извлечении. Встроенный векторный поиск обрабатывает многомерные встраивания для поддержки этих запросов. Выходные данные отражают качество индекса и встраивания, поэтому командам следует проверять кэшированные ответы на соответствие данным их приложения, прежде чем полагаться на них для фактических или высокостратегических решений.
Какие среды и клиенты он поддерживает?
Модель распространения представляет собой один двоичный файл Go, что упрощает развертывание на системах, которые могут выполнять программы Go. Инструмент реализует протокол Redis, так что существующие клиенты Redis и кодовые базы могут взаимодействовать без значительных изменений. Для рабочих процессов агентов он интегрируется с любым клиентом ИИ или платформой, которая поддерживает протокол контекста модели, с названными примерами, включая Claude Desktop и Cursor, что позволяет агентам получать доступ к данным напрямую.
Легко ли его внедрить в существующие стеки?
Внедрение сосредоточено на эргономике разработчиков и готовности к открытым исходным кодам. Лицензия BSD-3-Clause и проект, размещенный на GitHub, делают повторное использование кода простым, а опыт разработчика в бэкенд-системах, Node.js, TypeScript и Go предполагает акцент на API и дисциплине развертывания. Поскольку инструмент нацелен на инженеров и строителей агентов ИИ, ожидайте рабочего процесса, ориентированного на разработку, который предпочитает интеграцию репозиториев, конфигурацию на уровне кода и итеративное тестирование, а не графическое администрирование.
Кто должен рассмотреть этот инструмент
Инструмент является прагматичным выбором для инженерных команд, создающих сервисы с поддержкой агентов, которым необходима локальная выборка и контроль разработчиков. Его открытая ориентация поддерживает интеграцию, основанную на репозиториях, но командам следует проверять результаты семантического кэша на соответствие их наборам данных и подтверждать, что их агенты могут получить доступ к хранилищу через требуемый контекстный протокол перед развертыванием в большом масштабе. Рассматривайте это как инженерный компонент, а не как продукт для конечного пользователя plug-and-play.